Op deze pagina
Een regel voor alle AI-bedrijven tegelijk
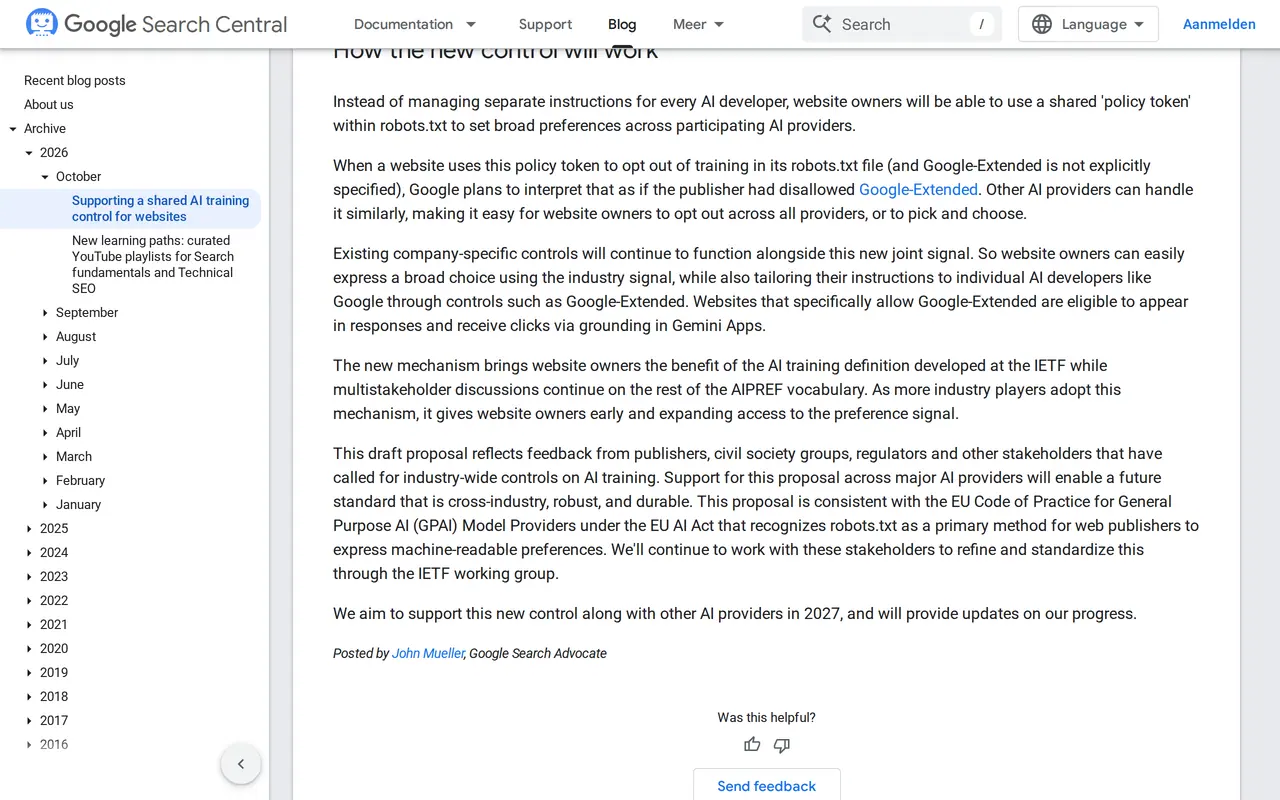
Robots.txt AI training krijgt een gedeelde regel. Google schreef op 30 oktober 2026 op zijn blog voor site-eigenaars dat het een gedeelde policy token in robots.txt wil ondersteunen. Met die ene regel zeg je aan alle deelnemende AI-aanbieders tegelijk of ze je inhoud mogen gebruiken om modellen te trainen. OpenAI meldde dezelfde dag dat het dat gedeelde signaal ook zal volgen.
Vandaag werkt het anders. Elk AI-bedrijf heeft een eigen naam voor zijn crawler of zijn token, en wie training wil weigeren, schrijft een regel per bedrijf. De nieuwe regel komt uit de AIPREF-werkgroep van de IETF, de organisatie achter de standaard voor robots.txt zelf. Google mikt op 2027 en geeft nog geen syntaxis. Je hoeft dus nu niets te veranderen, maar het is een goed moment om te weten wat je robots.txt vandaag zegt.
Training weigeren is iets anders dan uit Zoeken verdwijnen
Google-Extended weigerenrobots.txt, vandaag
AI Overviews en AI-modusgeen effect
Gewone resultatengeen effect
Gedeelde regel: training weigerenrobots.txt, gepland voor 2027
AI Overviews en AI-modusniet vermeld
Gewone resultatenniet vermeld
Generatieve AI uitzettenSearch Console
Training van Geminigeen effect
Grounding in Gemini-appsgeen effect
Gewone resultatengeen effect
noindexper pagina
Training van Geminidaar dient het niet voor
Grounding in Gemini-appsdaar dient het niet voor
Googlebot weigerenrobots.txt
Training van Geminidaar dient het niet voor
Grounding in Gemini-appsdaar dient het niet voor
geen effectnog niet bekendstopt of verdwijnt
Volgens de documentatie van Google op 1 november 2026. De syntaxis van de gedeelde regel ligt nog niet vast.
Wat Google precies aankondigde
Het bericht op de Search Central-blog is kort en voorzichtig geformuleerd. Dit zijn de punten die vastliggen:
- Er komt een gedeelde token in robots.txt waarmee je een brede voorkeur instelt bij alle AI-aanbieders die meedoen. Google noemt het een policy token.
- De definitie van AI-training komt van de AIPREF-werkgroep van de IETF. De rest van de woordenschat van die werkgroep ligt nog op tafel.
- Weiger je training via de gedeelde token en zeg je niets apart over Google-Extended, dan leest Google dat alsof je Google-Extended weigert.
- De regels per bedrijf blijven werken. Je kan dus een brede keuze maken en per aanbieder een uitzondering schrijven.
- Sites die Google-Extended uitdrukkelijk toelaten, blijven in aanmerking komen om te verschijnen in antwoorden van de Gemini-apps, met kliks naar de bron.
- Google wil het samen met andere AI-aanbieders in 2027 ondersteunen en belooft updates.
Wat ontbreekt: de exacte schrijfwijze van de regel, de lijst van deelnemende bedrijven en een datum. Kopieer dus nog geen voorbeeldregel van een forum; tot de standaard er is, doet zo'n regel niets.
Wat Google-Extended vandaag al doet
Google-Extended bestaat sinds 28 september 2023. Het is geen aparte crawler maar een token: Google haalt je pagina's op met zijn gewone crawlers en kijkt naar de regel voor Google-Extended om te beslissen of hij ze mag gebruiken voor het trainen van toekomstige Gemini-modellen en voor grounding, het onderbouwen van antwoorden in de Gemini-apps en de Vertex AI API. Google schrijft in zijn documentatie dat de token geen invloed heeft op je opname in Google Zoeken en geen rankingsignaal is.
Dat laatste is de bron van veel verwarring. Google-Extended weigeren haalt je niet uit AI Overviews en de AI-modus. Daarvoor bestaat sinds 31 augustus 2026 een aparte keuze in Search Console. En omgekeerd stopt die keuze in Search Console de training niet. Het zijn twee knoppen voor twee vragen.
| Regel of keuze | Training van Gemini-modellen | Grounding in de Gemini-apps | AI Overviews en AI-modus | Gewone zoekresultaten |
|---|---|---|---|---|
| Google-Extended weigeren in robots.txt | Stopt | Stopt | Geen effect | Geen effect |
| Gedeelde token: training weigeren (2027) | Stopt, als je Google-Extended niet apart toelaat | Stopt, tenzij je Google-Extended toelaat | Niet vermeld | Niet vermeld |
| Generatieve AI in Zoeken uitzetten in Search Console | Geen effect | Geen effect | Je verdwijnt eruit | Geen effect |
| noindex op een pagina | Daar dient het niet voor | Daar dient het niet voor | De pagina verdwijnt | De pagina verdwijnt |
| Googlebot weigeren in robots.txt | Daar dient het niet voor | Daar dient het niet voor | Google crawlt je pagina's niet meer | Je verdwijnt grotendeels uit Zoeken |
Kijk met de AI-crawler-checker wat je robots.txt vandaag zegt tegen Google-Extended en tegen de crawlers van andere AI-bedrijven. Veel sites weigeren training zonder het te weten, omdat een plug-in of een sjabloon de regels ooit toevoegde.
Waarom een gedeelde regel nodig is
Wie vandaag training wil weigeren, houdt een lijst bij van crawlers en tokens van tientallen bedrijven, en die lijst veroudert elke maand. Een kleine site doet dat niet, dus beslist in de praktijk het sjabloon of de hostingpartij. De IETF-werkgroep AI Preferences werkt aan een gedeelde woordenschat voor zulke voorkeuren en aan de manieren om ze aan je inhoud te hangen: via robots.txt, via een vast adres op je domein (een well-known URI) en via HTTP-headers. Robots.txt zelf is sinds 2022 een IETF-standaard, RFC 9309; de nieuwe token bouwt daarop voort.
Voor jou als ondernemer betekent dat: een regel, een keer geschreven, die geldt voor elk bedrijf dat de standaard volgt. Bedrijven die niet meedoen, volgen hem niet. Robots.txt blijft een verzoek, geen slot.
Wat dit niet verandert
De aankondiging gaat over training. Of je pagina's verschijnen in AI-antwoorden van ChatGPT, Perplexity of Google, hangt af van andere dingen: of hun zoekcrawlers je pagina's mogen lezen, of je pagina de vraag beantwoordt, en of andere bronnen je noemen. Wie training weigert, kan dus nog altijd als bron verschijnen; wie training toelaat, wordt daardoor niet vanzelf vaker geciteerd.
Ook de Europese regels staan los hiervan. De AI-verordening legt aanbieders van AI-modellen plichten op over transparantie, maar je robots.txt blijft de plek waar je zelf je voorkeur zegt.
Training toelaten of weigeren: de afweging voor een kmo
- Wat AI over je weet
- ToelatenJe diensten, je regio en je manier van werken kunnen in toekomstige modellen terechtkomen
- WeigerenHet model kent je alleen via wat anderen over je schrijven
- Antwoorden met bron
- ToelatenJe blijft in aanmerking voor grounding in de Gemini-apps, met een klik naar je site
- WeigerenWeiger je Google-Extended, dan valt ook die grounding weg
- Je eigen werk
- ToelatenJe tekst kan bijdragen aan een model zonder vergoeding
- WeigerenJe houdt je teksten buiten de training van wie de regel volgt
- Wie wint erbij
- ToelatenDienstverleners en lokale bedrijven die gevonden willen worden
- WeigerenUitgevers, makers en wie van zijn inhoud zelf leeft
Verkoop je een dienst of een product, dan wil je meestal dat AI je kent en naar je verwijst. Is je inhoud zelf je product, dan is weigeren verdedigbaar. Beslis het een keer bewust in plaats van het aan een plug-in over te laten.
Training weigeren zonder uit Google te verdwijnen
Moet ik nu al iets aanpassen?
Nee. De regel heeft nog geen syntaxis en Google mikt op 2027. Je bestaande regels voor Google-Extended en andere crawlers blijven werken.
Verlies ik plaatsen in Google als ik training weiger?
Nee. Google schrijft dat Google-Extended geen invloed heeft op je opname in Zoeken en geen rankingsignaal is.
Haalt het weigeren van training me uit AI Overviews?
Nee. Daarvoor dient de keuze Generatieve AI in Zoeken in Search Console, sinds 31 augustus 2026.
Volgen alle AI-bedrijven de gedeelde regel?
Alleen wie meedoet. Google en OpenAI kondigden het aan; andere namen zijn nog niet bekend. Robots.txt is een verzoek, geen technische blokkade.
Wat als ik de gedeelde regel gebruik en Google-Extended toelaat?
Dan wint je specifieke regel voor Google. Je weigert training bij de andere deelnemers en blijft beschikbaar voor Google, inclusief grounding in de Gemini-apps.
Wat je nu al kan doen
- Open je robots.txt op jouwsite.be/robots.txt en lees wat er staat. Zie je regels voor Google-Extended of voor andere AI-crawlers, ga dan na wie ze toevoegde en waarom.
- Beslis per doel. Training is een andere vraag dan verschijnen in AI-antwoorden. Wil je in ChatGPT gevonden worden, laat dan in elk geval de zoekcrawlers van die diensten toe.
- Leg je keuze vast, zodat een nieuwe plug-in of een nieuw sjabloon ze niet stil terugdraait. Een korte notitie bij je site volstaat.
- Meet wat AI vandaag met je doet. Het AI-rapport in Search Console toont je vertoningen in de AI-functies van Google.
- Volg de standaard. Zodra Google de syntaxis publiceert, schrijven we hier de regel uit die je kan kopiëren.
Wat wij hiermee doen
We bouwen sites die AI makkelijk kan lezen en citeren, met heldere pagina's per dienst, gestructureerde gegevens en een robots.txt die zegt wat de eigenaar wil. Bij elke SEO-opdracht kijken we ook naar de regels voor AI-crawlers. Wil je weten hoe je in AI-antwoorden verschijnt, lees dan de pagina over vindbaar worden in ChatGPT of de vergelijking SEO of GEO.