Op deze pagina
- 01Welke AI-bots kmo's weren
- 02Cloudflare schreef 341 van de 741 blokkades
- 03Met een eigen Cloudflare-account weert een op de vijf sites een AI-bot
- 04De Europese regel waar Cloudflare naar verwijst
- 05Zoekbots van AI-assistenten blijven bijna overal binnen
- 06Zaken die gevonden willen worden, weren even vaak
- 07Per sector: zorg hoger door twee gedeelde bestanden
- 08Per provincie ongeveer gelijk
- 09Het platform bepaalt wie het bestand schrijft
- 10Waarom het cijfer hoger ligt dan in oktober
- 11Wat robots.txt niet toont
- 12Wat betekent dit voor jouw zaak?
In november 2026 sloot 3,1 procent van de 23.676 werkende Belgische kmo-websites minstens een AI-crawler met naam buiten in robots.txt: 741 sites. GPTBot van OpenAI stond op 569 ervan dicht. Bij 341 van die 741 sites kwamen de regels uit het blok dat Cloudflare zelf bovenaan robots.txt zet. Een zoek- of gebruikersbot van een AI-assistent weerde 0,7 procent: 167 sites.
Dat blok weert trainingsbots en laat zoekbots door. Wie zich zorgen maakt dat de eigen zaak uit ChatGPT verdwijnt, kan dus meestal gerust zijn. Wie net wil dat de eigen teksten geen model trainen, ziet dat het bij de meeste kmo's niet geregeld is: 96,9 procent weert geen enkele AI-bot. Deze studie telt beide kanten, per bot, per netwerk, per platform, per sector en per provincie.
Trainingsbots worden geweerd, zoekbots van AI-assistenten bijna nooit
AmazonbotAmazon, training
2,5%GPTBotOpenAI, training
2,4%CCBotCommon Crawl, open webarchief
2,2%Meta-ExternalAgentMeta, training
2,2%ClaudeBotAnthropic, training
1,9%Google-ExtendedGoogle, training
1,8%Applebot-ExtendedApple, training
1,7%Amzn-SearchBotAmazon, zoeken in een AI-assistent
0,3%PerplexityBotPerplexity, zoeken in een AI-assistent
0,3%ChatGPT-UserOpenAI, haalt op voor een gebruiker
0,2%OAI-SearchBotOpenAI, zoeken in een AI-assistent
0,1%Meta-ExternalFetcherMeta, haalt op voor een gebruiker
0,1%Claude-UserAnthropic, haalt op voor een gebruiker
0,1%Perplexity-UserPerplexity, haalt op voor een gebruiker
0,1%Claude-SearchBotAnthropic, zoeken in een AI-assistent
0,0%Amzn-UserAmazon, haalt op voor een gebruiker
0,0%
Procent van de werkende sites; geweerd betekent Disallow: / voor die bot in een eigen groep. Donkerblauw: bots die zoeken of ophalen voor een gebruiker. Gemeten op 5 november 2026.
Welke AI-bots kmo's weren
Elke grote AI-leverancier stuurt meer dan een bot op pad, en elke bot heeft een eigen taak. OpenAI gebruikt GPTBot om inhoud te verzamelen die zijn modellen kan trainen, OAI-SearchBot om sites te tonen in de zoekfunctie van ChatGPT en ChatGPT-User om een pagina op te halen als een gebruiker erom vraagt. Anthropic, Perplexity, Meta en Amazon maken dezelfde splitsing. Google-Extended en Applebot-Extended crawlen niet zelf: het zijn namen waarmee je zegt of wat Googlebot en Applebot al ophalen, ook voor AI-modellen mag dienen.
In november 2026 stond Amazonbot op 601 Belgische kmo-sites dicht (2,5 procent van 23.676), GPTBot op 569 (2,4 procent) en CCBot van Common Crawl op 532. Bots die trainen of een open archief bouwen, maken bijna alle blokkades uit: 714 van de 741 sites weren er minstens een. Zoekbots komen ver daarachter. OAI-SearchBot staat op 31 sites dicht, Claude-SearchBot op 8.
| Bot | Van | Taak volgens de leverancier | Sites die hem weren | Aandeel van 23.676 |
|---|---|---|---|---|
| Amazonbot | Amazon | Producten verbeteren, kan AI-modellen trainen | 601 | 2,5% |
| GPTBot | OpenAI | Training van modellen | 569 | 2,4% |
| CCBot | Common Crawl | Open archief van het web | 532 | 2,2% |
| meta-externalagent | Meta | Training en indexering | 519 | 2,2% |
| ClaudeBot | Anthropic | Training van modellen | 449 | 1,9% |
| Google-Extended | Gemini-training en grounding, crawlt niet zelf | 423 | 1,8% | |
| Applebot-Extended | Apple | Training van Apple-modellen, crawlt niet zelf | 401 | 1,7% |
| Amzn-SearchBot | Amazon | Zoeken in Amazon-diensten | 68 | 0,3% |
| PerplexityBot | Perplexity | Sites tonen en linken in Perplexity | 64 | 0,3% |
| ChatGPT-User | OpenAI | Ophalen op vraag van een gebruiker | 59 | 0,2% |
| OAI-SearchBot | OpenAI | Sites tonen in ChatGPT search | 31 | 0,1% |
| meta-externalfetcher | Meta | Ophalen op vraag van een gebruiker | 20 | 0,1% |
| Claude-User | Anthropic | Ophalen op vraag van een gebruiker | 16 | 0,1% |
| Perplexity-User | Perplexity | Ophalen op vraag van een gebruiker | 15 | 0,1% |
| Claude-SearchBot | Anthropic | Zoekresultaten van Claude verbeteren | 8 | 0,0% |
| Amzn-User | Amazon | Ophalen op vraag van een gebruiker | 7 | 0,0% |
Blokkeren gebeurt zelden per bot. Op 372 van de 741 sites staan precies zeven bots dicht, op 103 maar een. Of jouw eigen site een van deze zestien weert, lees je af met de AI-crawler-checker. Wat Google met een nieuwe regel voor AI-training van plan is, staat in ons stuk over robots.txt en AI-training.
Cloudflare schreef 341 van de 741 blokkades
Cloudflare is een netwerkdienst die voor een website staat en het verkeer filtert. Vanaf 1 juli 2025 vroeg Cloudflare elk nieuw domein bij de inschrijving of het AI-crawlers wilde toelaten. Wie de beheerde robots.txt aanzet, krijgt bovenaan robots.txt een blok tussen de regels '# BEGIN Cloudflare Managed content' en '# END Cloudflare Managed Content'. Dat blok weert acht bots met naam: Amazonbot, Applebot-Extended, Bytespider, CCBot, ClaudeBot, Google-Extended, GPTBot en meta-externalagent. In de groep voor alle bots staat een Content-Signal-regel die zoeken toelaat en training weigert; op de sites die we lazen, luidde die 'search=yes,ai-train=no,use=reference'.
In november 2026 droegen 352 Belgische kmo-sites dat blok. Bij 341 van de 741 sites die een AI-bot weren, komt de hele blokkade uit dat blok (46,0 procent); nog eens 10 vulden het aan met eigen namen. Een gedeeld bestand, dezelfde regels op vijf of meer sites, verklaart 204 blokkades (27,5 procent). De grootste twee staan op 63 en 56 sites. Eigen regels die we nergens anders zagen, staan op 196 sites (26,5 procent).
Bijna de helft van de blokkades schreef Cloudflare
Beheerde robots.txt van Cloudflarehet blok dat Cloudflare zelf schrijft, 341 sites
46,0%Gedeeld bestanddezelfde regels op vijf of meer sites, 204 sites
27,5%Eigen regelseen lijst die we nergens anders zagen, 196 sites
26,5%
Procent van de sites die minstens een AI-bot met naam weren. Gemeten op 5 november 2026.
Het blok van Cloudflare laat de zoekbots van AI-assistenten door. Op 343 van de 352 sites met het blok mocht elke zoek- en gebruikersbot uit onze lijst nog binnen. Wie zo'n blok heeft, verdwijnt dus niet uit ChatGPT search of Perplexity; zijn teksten gaan wel niet naar de trainingsbots die zich aan robots.txt houden.
Cloudflare schuift zelf op. Sinds 1 juli 2026 kun je zoeken, agents en training apart regelen, ook op het gratis plan. Op 15 september 2026 kondigde Cloudflare aan dat de beheerde robots.txt verdwijnt voor een nieuw systeem, Bot Preference Sync, en dat klanten met het oude blok daarnaar overgezet worden. Nieuwe domeinen zonder advertenties laten sindsdien zoeken, agents en training toe. De bestanden die we op 5 november 2026 lazen, droegen nog het oude blok.
Met een eigen Cloudflare-account weert een op de vijf sites een AI-bot
Of een site achter Cloudflare staat, lees je af aan de headers van de startpagina: de server-header of een cf-ray. In november 2026 gold dat voor 3.953 van de 23.676 kmo-sites (16,7 procent). Ze dragen samen 53,0 procent van alle blokkades. Een groot deel van die 3.953 draait op een bouwplatform als Wix, Shopify of Webflow, dat zelf achter Cloudflare staat; daar beheert de ondernemer de instellingen van Cloudflare niet. Daarom splitsen we die groep.
| Netwerk | Sites | Weert een AI-bot | Aandeel | Met het blok van Cloudflare |
|---|---|---|---|---|
| Achter Cloudflare, geen bouwplatform | 1.761 | 374 | 21,2% | 321 |
| Bouwplatform achter Cloudflare | 2.192 | 19 | 0,9% | 12 |
| Niet achter Cloudflare | 19.723 | 348 | 1,8% | 19 |
| Alle werkende sites | 23.676 | 741 | 3,1% | 352 |
Op sites met een eigen Cloudflare-account weert 21,2 procent een AI-bot, tegen 1,8 procent buiten Cloudflare. Bij 321 van die 374 sites staat het blok van Cloudflare letterlijk in het bestand. Het verschil is dus geen gok over een oorzaak: de regels zijn die van Cloudflare zelf. Op de 19 sites buiten Cloudflare met het blok kopieerde iemand het bestand, of verhuisde de site weg van Cloudflare.
Achter Cloudflare weert een op de vijf sites AI-bots
Alle werkende sites: 3,1%
Achter Cloudflarebuiten de bouwplatformen, 1.761 sites
21,2%Bouwplatform achter CloudflareWix, Shopify, Webflow en andere, 2.192 sites
0,9%Niet achter Cloudflarevolgens de headers van de startpagina, 19.723 sites
1,8%
Procent van de werkende sites per groep. Cloudflare herkend aan de server-header of een cf-ray. Gemeten op 5 november 2026.
De Europese regel waar Cloudflare naar verwijst
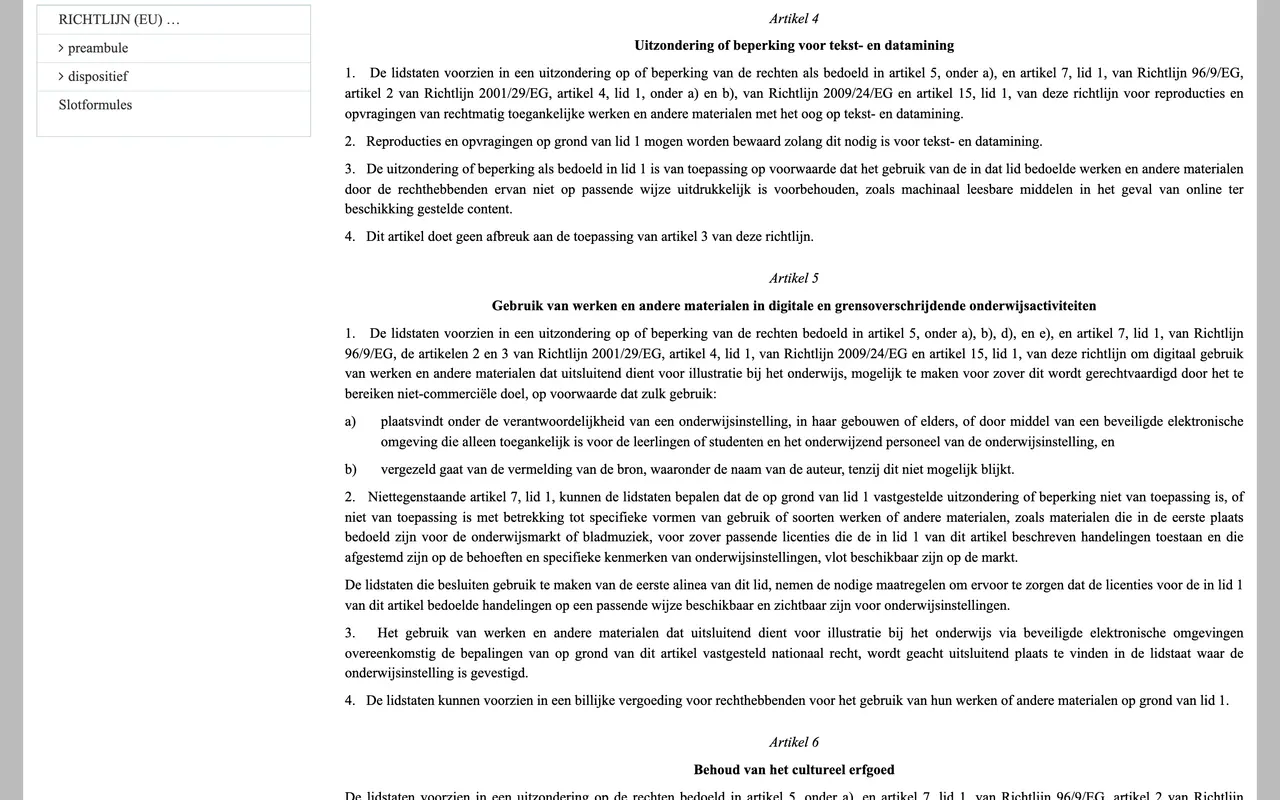
Op 425 kmo-sites staat in robots.txt een lange tekst van Cloudflare die naar artikel 4 van richtlijn (EU) 2019/790 verwijst, de Europese richtlijn over auteursrecht in de digitale eengemaakte markt. Artikel 4 laat tekst- en datamining toe op werken die rechtmatig toegankelijk zijn. Lid 3 legt de grens: de uitzondering geldt alleen als de rechthebbende het gebruik niet 'op passende wijze uitdrukkelijk' heeft voorbehouden, 'zoals machinaal leesbare middelen' bij online content. De tekst van Cloudflare noemt beperkingen via Content Signals zo'n uitdrukkelijk voorbehoud onder dat artikel.
In november 2026 zei de Content-Signal-regel op 386 kmo-sites ai-train=no. Op 75 sites stond de tekst zonder die regel, zodat er niets voorbehouden wordt behalve wat de bots met naam al weigeren. Op 145 sites zei de regel het omgekeerde, ai-train=yes. Daarvan draaien er 132 op Ecwid, waar telkens dezelfde regel 'search=yes,ai-input=yes,ai-train=yes' staat.
Zoekbots van AI-assistenten blijven bijna overal binnen
In november 2026 weerde 0,7 procent van de 23.676 Belgische kmo-sites een bot waarmee een AI-assistent zoekt of een pagina ophaalt voor een gebruiker: 167 sites. Een zoekbot staat op 149 sites dicht, maar Amzn-SearchBot van Amazon maakt het grootste deel uit; zonder die bot zijn het er 84. De bots die voor een gebruiker ophalen, zoals ChatGPT-User en Claude-User, staan op 63 sites dicht.
Wat zo'n blokkade kost, zeggen de leveranciers zelf. OpenAI toont sites die OAI-SearchBot weren niet in de zoekantwoorden van ChatGPT. Anthropic indexeert een site die Claude-SearchBot weert niet voor zijn zoekfunctie. PerplexityBot toont en linkt sites in Perplexity en dient niet voor het trainen van modellen. Het verschil tussen de twee grote assistenten lees je in Perplexity of ChatGPT. Hoe je in hun antwoorden komt, staat in de gids hoe word je vindbaar in ChatGPT, en wat GEO daaraan toevoegt, in ons begrip.
Google-Extended weren kost je niets in Google zelf. Google zegt dat die naam niet bepaalt of een site in Google Search staat en geen rankingsignaal is. Van de 423 kmo-sites die Google-Extended weren, weert geen enkele ook Googlebot. Apple zegt hetzelfde over Applebot-Extended: pagina's die het weren, blijven in de zoekresultaten. Wie de AI-overzichten in Google wil uitzetten, heeft daar een andere knop voor, zie AI-overzichten uitschakelen voor je site.
Zaken die gevonden willen worden, weren even vaak
De vraag achter deze studie: sluiten zaken die net gevonden willen worden, AI-assistenten buiten? We keken naar drie tekenen in de HTML van de startpagina: een lokaal bedrijfsschema (LocalBusiness of een subtype zoals Restaurant of Dentist, niet Organization alleen), een widget met Google-reviews en een belknop met een tel-link. Hoe zo'n schema werkt, lees je bij schema markup.
| Groep | Sites | Weert een AI-bot | Weert een zoek- of gebruikersbot |
|---|---|---|---|
| Lokaal bedrijfsschema of Google-reviewswidget | 4.476 | 2,9% | 0,5% |
| Belknop met tel-link | 11.204 | 3,9% | 1,1% |
| Minstens een van de drie | 12.538 | 3,7% | 1,0% |
| Geen van de drie | 9.435 | 2,7% | 0,4% |
| Startpagina vraagt JavaScript, niet gelezen | 1.703 | 1,4% | 0,1% |
In november 2026 weerden 125 van de 12.538 Belgische kmo-sites die zo'n teken tonen, een zoek- of gebruikersbot van een AI-assistent. Dat is 1,0 procent. Bij sites zonder die tekenen is het 0,4 procent. Het verschil blijft onder 5 procentpunt: ongeveer gelijk. Wie gevonden wil worden, ziet dus zelden zijn zoekbots dicht; wel weert 3,7 procent een trainingsbot of een andere AI-bot. Meer reviews verzamelen doe je met de stappen in meer Google-reviews krijgen.
Per sector: zorg hoger door twee gedeelde bestanden
| Sector | Sites | Weert een AI-bot | Weert GPTBot | Weert een zoek- of gebruikersbot | Achter Cloudflare |
|---|---|---|---|---|---|
| Horeca | 8.126 | 2,0% | 1,8% | 0,3% | 15,9% |
| Handel | 6.955 | 3,7% | 2,9% | 0,6% | 19,5% |
| Zakelijke diensten | 2.767 | 3,3% | 2,5% | 0,5% | 14,0% |
| Zorg | 2.429 | 6,3% | 4,0% | 2,9% | 14,8% |
| Verzorging en vrije tijd | 1.430 | 2,3% | 1,7% | 0,6% | 19,2% |
| Bouw en vakmensen | 1.330 | 1,7% | 1,4% | 0,4% | 14,7% |
| Auto | 639 | 3,4% | 2,2% | 0,2% | 13,5% |
| Alle sites | 23.676 | 3,1% | 2,4% | 0,7% | 16,7% |
Zorg ligt het hoogst met 6,3 procent van 2.429 sites, maar dat komt grotendeels uit twee bestanden die letterlijk op 63 en 56 zorgsites staan. Het grootste, op Magento, weert ook Amzn-SearchBot; daardoor komt zorg op 2,9 procent bij de zoekbots. Laat je die twee bestanden weg, dan weert 1,5 procent van de overige 2.310 zorgsites een AI-bot. Tussen de andere sectoren blijft elk verschil onder 5 procentpunt: ongeveer gelijk.
Per provincie ongeveer gelijk
In november 2026 weerde in elke provincie tussen 2,0 en 4,4 procent van de kmo-sites een AI-bot. Vlaams-Brabant ligt het hoogst, Waals-Brabant het laagst, maar het verschil blijft ver onder 5 procentpunt. Ook het aandeel achter Cloudflare ligt overal tussen 10,9 en 20,3 procent.
| Provincie | Sites | Weert een AI-bot | Weert GPTBot | Weert een zoek- of gebruikersbot | Achter Cloudflare |
|---|---|---|---|---|---|
| Antwerpen | 4.111 | 3,0% | 2,2% | 0,6% | 17,0% |
| Oost-Vlaanderen | 3.839 | 3,4% | 2,7% | 0,9% | 16,2% |
| West-Vlaanderen | 3.459 | 3,0% | 2,3% | 0,8% | 13,2% |
| Vlaams-Brabant | 2.523 | 4,4% | 3,0% | 0,9% | 19,1% |
| Brussel | 2.393 | 2,6% | 2,0% | 0,3% | 20,3% |
| Limburg | 1.938 | 3,9% | 2,9% | 0,6% | 18,3% |
| Luik | 1.621 | 2,6% | 2,3% | 0,6% | 14,0% |
| Henegouwen | 1.245 | 2,4% | 2,0% | 0,9% | 16,8% |
| Waals-Brabant | 1.077 | 2,0% | 1,7% | 0,3% | 20,2% |
| Namen | 836 | 3,5% | 3,0% | 1,0% | 16,0% |
| Luxemburg | 634 | 2,1% | 1,9% | 1,1% | 10,9% |
Overal tussen 2 en 4,5 procent
Procent van de werkende sites per provincie; de provincie komt uit het adres in OpenStreetMap.
Het platform bepaalt wie het bestand schrijft
Op een bouwplatform schrijft het platform robots.txt, op een eigen installatie de webbouwer of de ondernemer. Dat zie je in de cijfers. Op Magento weert 43,2 procent van 185 kmo-sites een AI-bot, op PrestaShop 16,1 procent van 174 en op Craft CMS 13,1 procent van 183, tegen 2,2 procent op WordPress. Bij Magento komt het grootste deel uit het gedeelde bestand van 63 zorgsites. Op Wix, one.com, JouwWeb en Proxi weerde haast niemand een AI-bot.
| Platform | Sites | Weert een AI-bot | Weert een zoek- of gebruikersbot | Achter Cloudflare |
|---|---|---|---|---|
| WordPress | 7.902 | 2,2% | 0,3% | 7,8% |
| Geen platform herkend | 7.359 | 4,1% | 0,6% | 11,0% |
| Wix | 1.515 | 0,2% | 0,0% | 74,9% |
| Drupal | 907 | 2,5% | 0,2% | 7,6% |
| one.com Builder | 887 | 0,1% | 0,0% | 0,1% |
| Shopify | 631 | 1,0% | 0,2% | 94,5% |
| Squarespace | 501 | 0,8% | 0,0% | 2,4% |
| Odoo | 398 | 6,5% | 0,3% | 7,3% |
| Joomla | 335 | 1,2% | 0,3% | 3,0% |
| Next.js | 316 | 9,5% | 0,6% | 16,5% |
| Ecwid | 306 | 3,9% | 0,3% | 1,6% |
| Webflow | 275 | 2,9% | 1,8% | 88,4% |
| JouwWeb | 255 | 0,0% | 0,0% | 0,0% |
| Proxi | 252 | 0,0% | 0,0% | 0,0% |
| Magento | 185 | 43,2% | 35,1% | 23,8% |
| Craft CMS | 183 | 13,1% | 9,3% | 5,5% |
| PrestaShop | 174 | 16,1% | 2,3% | 19,0% |
Squarespace heeft een vakje 'Block known artificial intelligence crawlers' dat standaard uit staat. Het standaardbestand van Squarespace noemt wel AI-bots bij naam, maar laat de startpagina voor hen open: zo stond het op 478 van de 501 Squarespace-sites. WordPress.com heeft de optie 'Prevent third-party sharing', die bekende AI-bots aan robots.txt toevoegt. Op welk platform een site draait, zie je met de CMS-checker. Twijfel je tussen twee platformen, lees dan Squarespace of WordPress of Wix of WordPress.
Waarom het cijfer hoger ligt dan in oktober
In de staat van de kmo-website 2026 weerde 0,6 procent van de sites GPTBot: 3 van de 477 sites die antwoordden, uit een steekproef van 586. Deze studie komt op 2,4 procent voor GPTBot en 3,1 procent voor minstens een AI-bot. We lazen de bewaarde bestanden van oktober opnieuw met onze parser en vonden dezelfde 3. Het verschil komt dus niet uit een andere manier van lezen.
| Meting | Sites | Weert GPTBot | Aandeel |
|---|---|---|---|
| Steekproef van oktober 2026 | 477 | 3 | 0,6% |
| Dezelfde 477 sites, 5 november 2026, met naam | 477 | 6 | 1,3% |
| Dezelfde 477 sites, ook via User-agent: * | 477 | 7 | 1,5% |
| Volledige telling, 5 november 2026 | 23.676 | 569 | 2,4% |
Vier dingen verklaren de rest. Ten eerste veranderden de bestanden: op dezelfde 477 sites kwamen er in een maand vier blokkades bij, drie daarvan via het blok van Cloudflare en een via een regel die alles dichtzet. Op alle 764 domeinen van die steekproef ging het aantal bestanden met het blok van Cloudflare van 4 naar 8. Ten tweede gaf de steekproef elke sector evenveel gewicht, de telling volgt het volle kader. Ten derde telt de hoofdmaat hier zestien bots, niet alleen GPTBot. Ten vierde is 3 van 477 een klein getal, waarin een paar sites het aandeel sterk verschuiven. De steekproef zag geen enkele site die de zoekbots van ChatGPT, Claude of Perplexity weerde; op 477 sites valt een aandeel van 0,7 procent makkelijk op nul.
Wat robots.txt niet toont
robots.txt is een verzoek. Cloudflare schrijft zelf dat bots die regels kunnen negeren. OpenAI, Meta, Amazon en Perplexity zeggen dat hun bots die ophalen op vraag van een gebruiker, robots.txt niet altijd volgen. Een blokkade in het netwerk, zoals een firewallregel of een blokkade in de instellingen van Cloudflare, weigert een bot zonder dat robots.txt het vermeldt. Die zie je alleen door je als die bot voor te doen, en dat deden we niet: we vroegen elke pagina op met een herkenbare naam van ons eigen onderzoek. Het echte aandeel sites dat AI-bots buitensluit, ligt dus hoger dan wat robots.txt laat zien.
Ook buiten de telling vielen 370 domeinen die in robots.txt elke bot zonder naam weren. 218 daarvan laten Googlebot wel binnen, 152 sluiten ook Google uit, en 359 weren GPTBot. Onder de werkende sites zetten maar 2 sites alles dicht voor elke bot. Hoe robots.txt, crawlen en indexeren samenhangen, lees je in technische SEO uitgelegd.
Wat betekent dit voor jouw zaak?
Een AI-bot weren is een keuze die je mag maken. Het gaat erom dat je weet wat er in je bestand staat en wie het erin zette. Zo pak je het aan:
- Lees je eigen robots.txt. Typ je domein in de AI-crawler-checker en kijk per bot of hij binnen mag.
- Kijk of Cloudflare voor je site staat. Staat het blok tussen '# BEGIN Cloudflare Managed content' en '# END Cloudflare Managed Content' in je bestand, dan komt het uit je account bij Cloudflare. Daar zet je zoeken, agents en training apart aan of uit.
- Beslis apart over training en zoeken. Wil je in ChatGPT, Claude of Perplexity opduiken, laat dan OAI-SearchBot, Claude-SearchBot en PerplexityBot binnen. Training weigeren kan tegelijk.
- Laat Googlebot met rust. Google-Extended weren raakt je plaats in Google niet; Googlebot weren wel. Wat zero-click zoeken voor je verkeer betekent, lees je bij zero-click.
- Maak je zaak leesbaar. Een lokaal bedrijfsschema, actuele openingsuren en reviews helpen elke zoekmachine. De tips voor lokale SEO zetten de basis op een rij.
- Vraag wie het bestand beheert. Je webbouwer, je host of je platform kan regels toevoegen zonder het te melden. Wil je dat iemand met je meekijkt, plan een gesprek of bekijk onze dienst vindbaar in ChatGPT.
Vragen over AI-bots en je robots.txt
Hoe blokkeer je AI-crawlers in robots.txt?
Met een eigen groep per bot: 'User-agent: GPTBot' met daaronder 'Disallow: /'. Elke leverancier publiceert de namen van zijn bots, en de meeste hebben aparte bots voor training en voor zoeken. Weer dus alleen wat je echt wil weren. In november 2026 deed 3,1 procent van 23.676 Belgische kmo-sites dat voor minstens een bot.
Blokkeert Cloudflare AI-crawlers standaard?
Niet meer voor nieuwe domeinen zonder advertenties: sinds 15 september 2026 laten die zoeken, agents en training toe. Nieuwe domeinen met advertenties weigeren training standaard. De oudere beheerde robots.txt zette je zelf aan, of kreeg je na de vraag bij je inschrijving. In november 2026 droegen 352 Belgische kmo-sites dat blok.
Is GPTBot blokkeren slecht voor je vindbaarheid in ChatGPT?
Nee. GPTBot verzamelt inhoud voor training. ChatGPT zoekt met OAI-SearchBot, en alleen sites die OAI-SearchBot weren, verschijnen niet in de zoekantwoorden van ChatGPT. Van de 569 Belgische kmo-sites die GPTBot weerden, lieten de meeste OAI-SearchBot binnen. Meer over gevonden worden in ChatGPT lees je in de gids.
Verdwijn je uit Google als je Google-Extended blokkeert?
Nee. Google-Extended regelt of Gemini je inhoud mag gebruiken voor training en grounding. Google zegt dat het niet bepaalt of je site in Google Search staat en geen rankingsignaal is. Geen van de 423 Belgische kmo-sites die Google-Extended weerden, sloot ook Googlebot uit.
Moeten AI-bots zich aan robots.txt houden?
robots.txt is een verzoek, geen slot. De grote leveranciers zeggen dat hun crawlers het volgen, maar bots die ophalen op vraag van een gebruiker volgen het niet altijd. In Europa geeft artikel 4, lid 3 van richtlijn 2019/790 een voorbehoud in machinaal leesbare vorm wel gewicht bij tekst- en datamining.
Hoeveel Belgische kmo's weren AI-crawlers?
In november 2026 weerde 3,1 procent van 23.676 werkende Belgische kmo-websites minstens een AI-crawler met naam, en 0,7 procent een zoek- of gebruikersbot. Achter een eigen Cloudflare-account was het 21,2 procent. De open data per sector, provincie en platform staan in de CSV bij deze studie.